開發生態
SemiWiki 技術分析:單純提高 HBM 頻寬無法等比提升 AI 效能,受限於運算強度與 Decode 階段容量瓶頸
SemiWiki單一來源
尚未逐項核實
目前依單一來源整理,這是來源數量描述,不是對消息真假的判定。
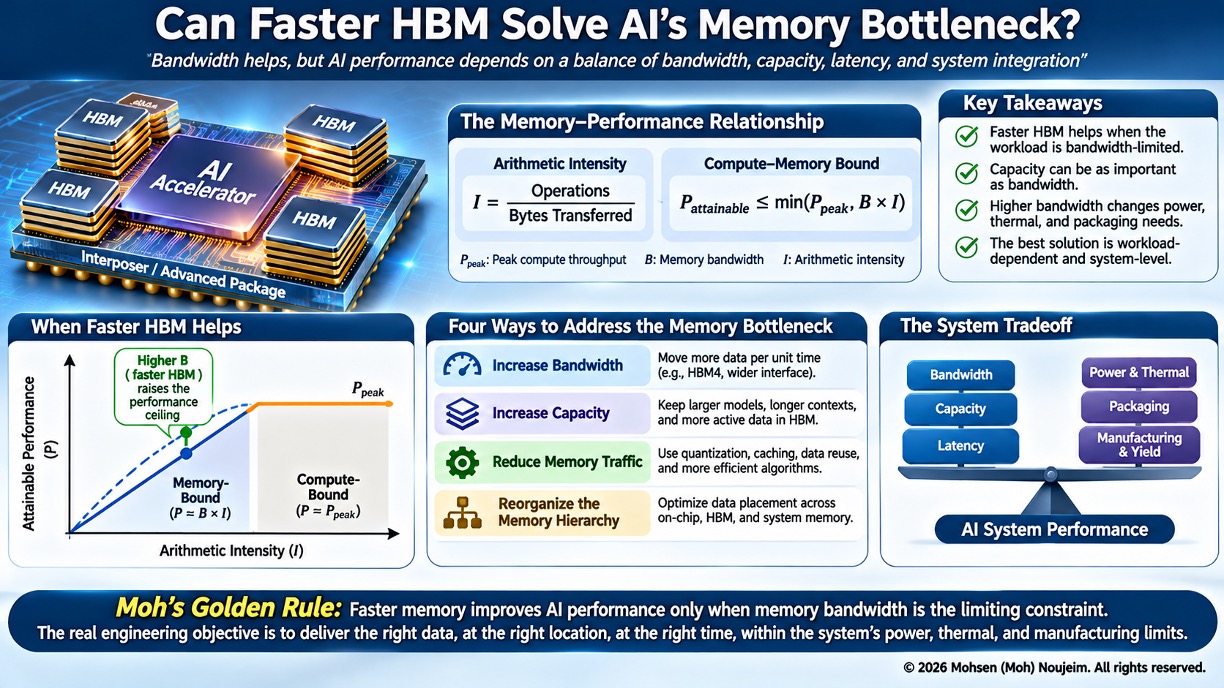
半導體技術網站 SemiWiki 發布分析指出,儘管 HBM4 藉由加寬介面與提升頻寬緩解加速晶片的資料傳輸壓力,但記憶體頻寬增長並不等於 AI 應用效能會等比例提升。根據 Roofline 效能模型,可達運算吞吐量由峰值運算力與「持續頻寬乘上運算強度(每位元組運算次數)」兩者的最小值決定;高運算強度的負載受限於算力上限,一旦接近運算極限,擴充 HBM 頻寬帶來的邊際效益將迅速遞減。
分析進一步區分訓練與推論的瓶頸差異:在大型語言模型推論中,Prefill 階段包含大量平行矩陣運算與資料重複利用,通常屬於運算受限(compute-bound);逐字生成的 Decode 階段則需重複搬移模型權重與注意力資料,運算量較低,增加 HBM 頻寬確實能改善 token 生成吞吐量。然而,頻寬與容量是相異限制,隨著 context length 增長與併發需求增加,Key-Value 快取(KV cache)將佔據大量 HBM 儲存空間,使系統面臨容量上限而非僅是傳輸速度問題。
讀原始報導