研究與評測
Appier 發表 LLM 研究:大型推理模型逾九成推理與回答語言不一致,DPO 訓練可提升 30% 拒答準確率
INSIDE單一來源
尚未逐項核實
目前依單一來源整理,這是來源數量描述,不是對消息真假的判定。
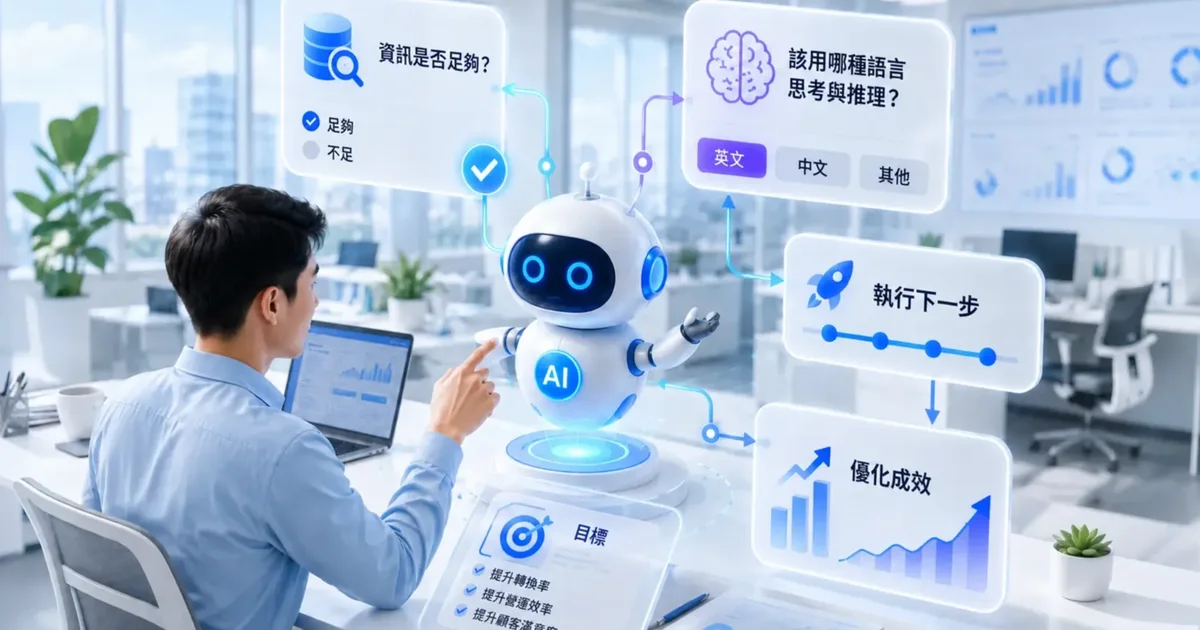
據報導,Appier AI 研究團隊發表兩篇關於大型語言模型(LLM)的研究論文,探討模型的推理語言選擇與辨識資訊缺口的能力。
在推理語言方面,研究指出大型推理模型(LRMs)即使接收不同語言提問,仍傾向依賴英文等高資源語言進行內部推理,部分模型的內部推理語言與最終回答語言不一致比例超過九成。團隊透過「文字預填法」(Text Prefilling)在提示詞中強制定義思考語言,結果顯示英文有利於數學與知識型任務的推理表現;但在文化理解與安全性測試中,使用在地語言推理更能貼近當地脈絡並精準攔阻違法提問。此研究開啟了「推理語言路由」(Reasoning-Language Routing)的應用可能,讓 Agentic AI 能依任務類型動態選用最適合的推理語言。
在辨識資訊缺口方面,團隊以「以上皆非」模擬無正解情境,測試 28 款主流 LLM。結果發現,當正確答案為「以上皆非」時,模型表現普遍下降 30% 至 50%,顯示模型在面對次優或錯誤選項時傾向硬答,而非主動表示資訊不足。實驗證實,透過直接偏好優化(DPO)同時納入正確與錯誤回答進行訓練,可將模型辨識「無正解」問題的準確率提升近 30 個百分點。
讀原始報導背景
代理型 AI(Agentic AI)是一種具備一定自主性的人工智慧程式,能夠主動追求目標、使用軟體工具並採取行動,有別於僅執行特定問答任務的傳統 AI。為了讓模型取得外部知識,業界常搭配檢索增強生成(RAG)技術,讓大型語言模型(LLM)在回應前先從外部資料來源擷取新資訊,藉此補充原有訓練資料並提升準確度。
來源
本期分類