研究與評測
開源 Qwen3-TTS 1.7B 實作:單張 H100 達成 10 RPS 下首音訊延遲低於 50ms,每百萬字元成本約 2 美元
Hacker News綜合 2 家報導多家報導
尚未逐項核實
多個報導來源提及此事;未必是彼此獨立的證據。
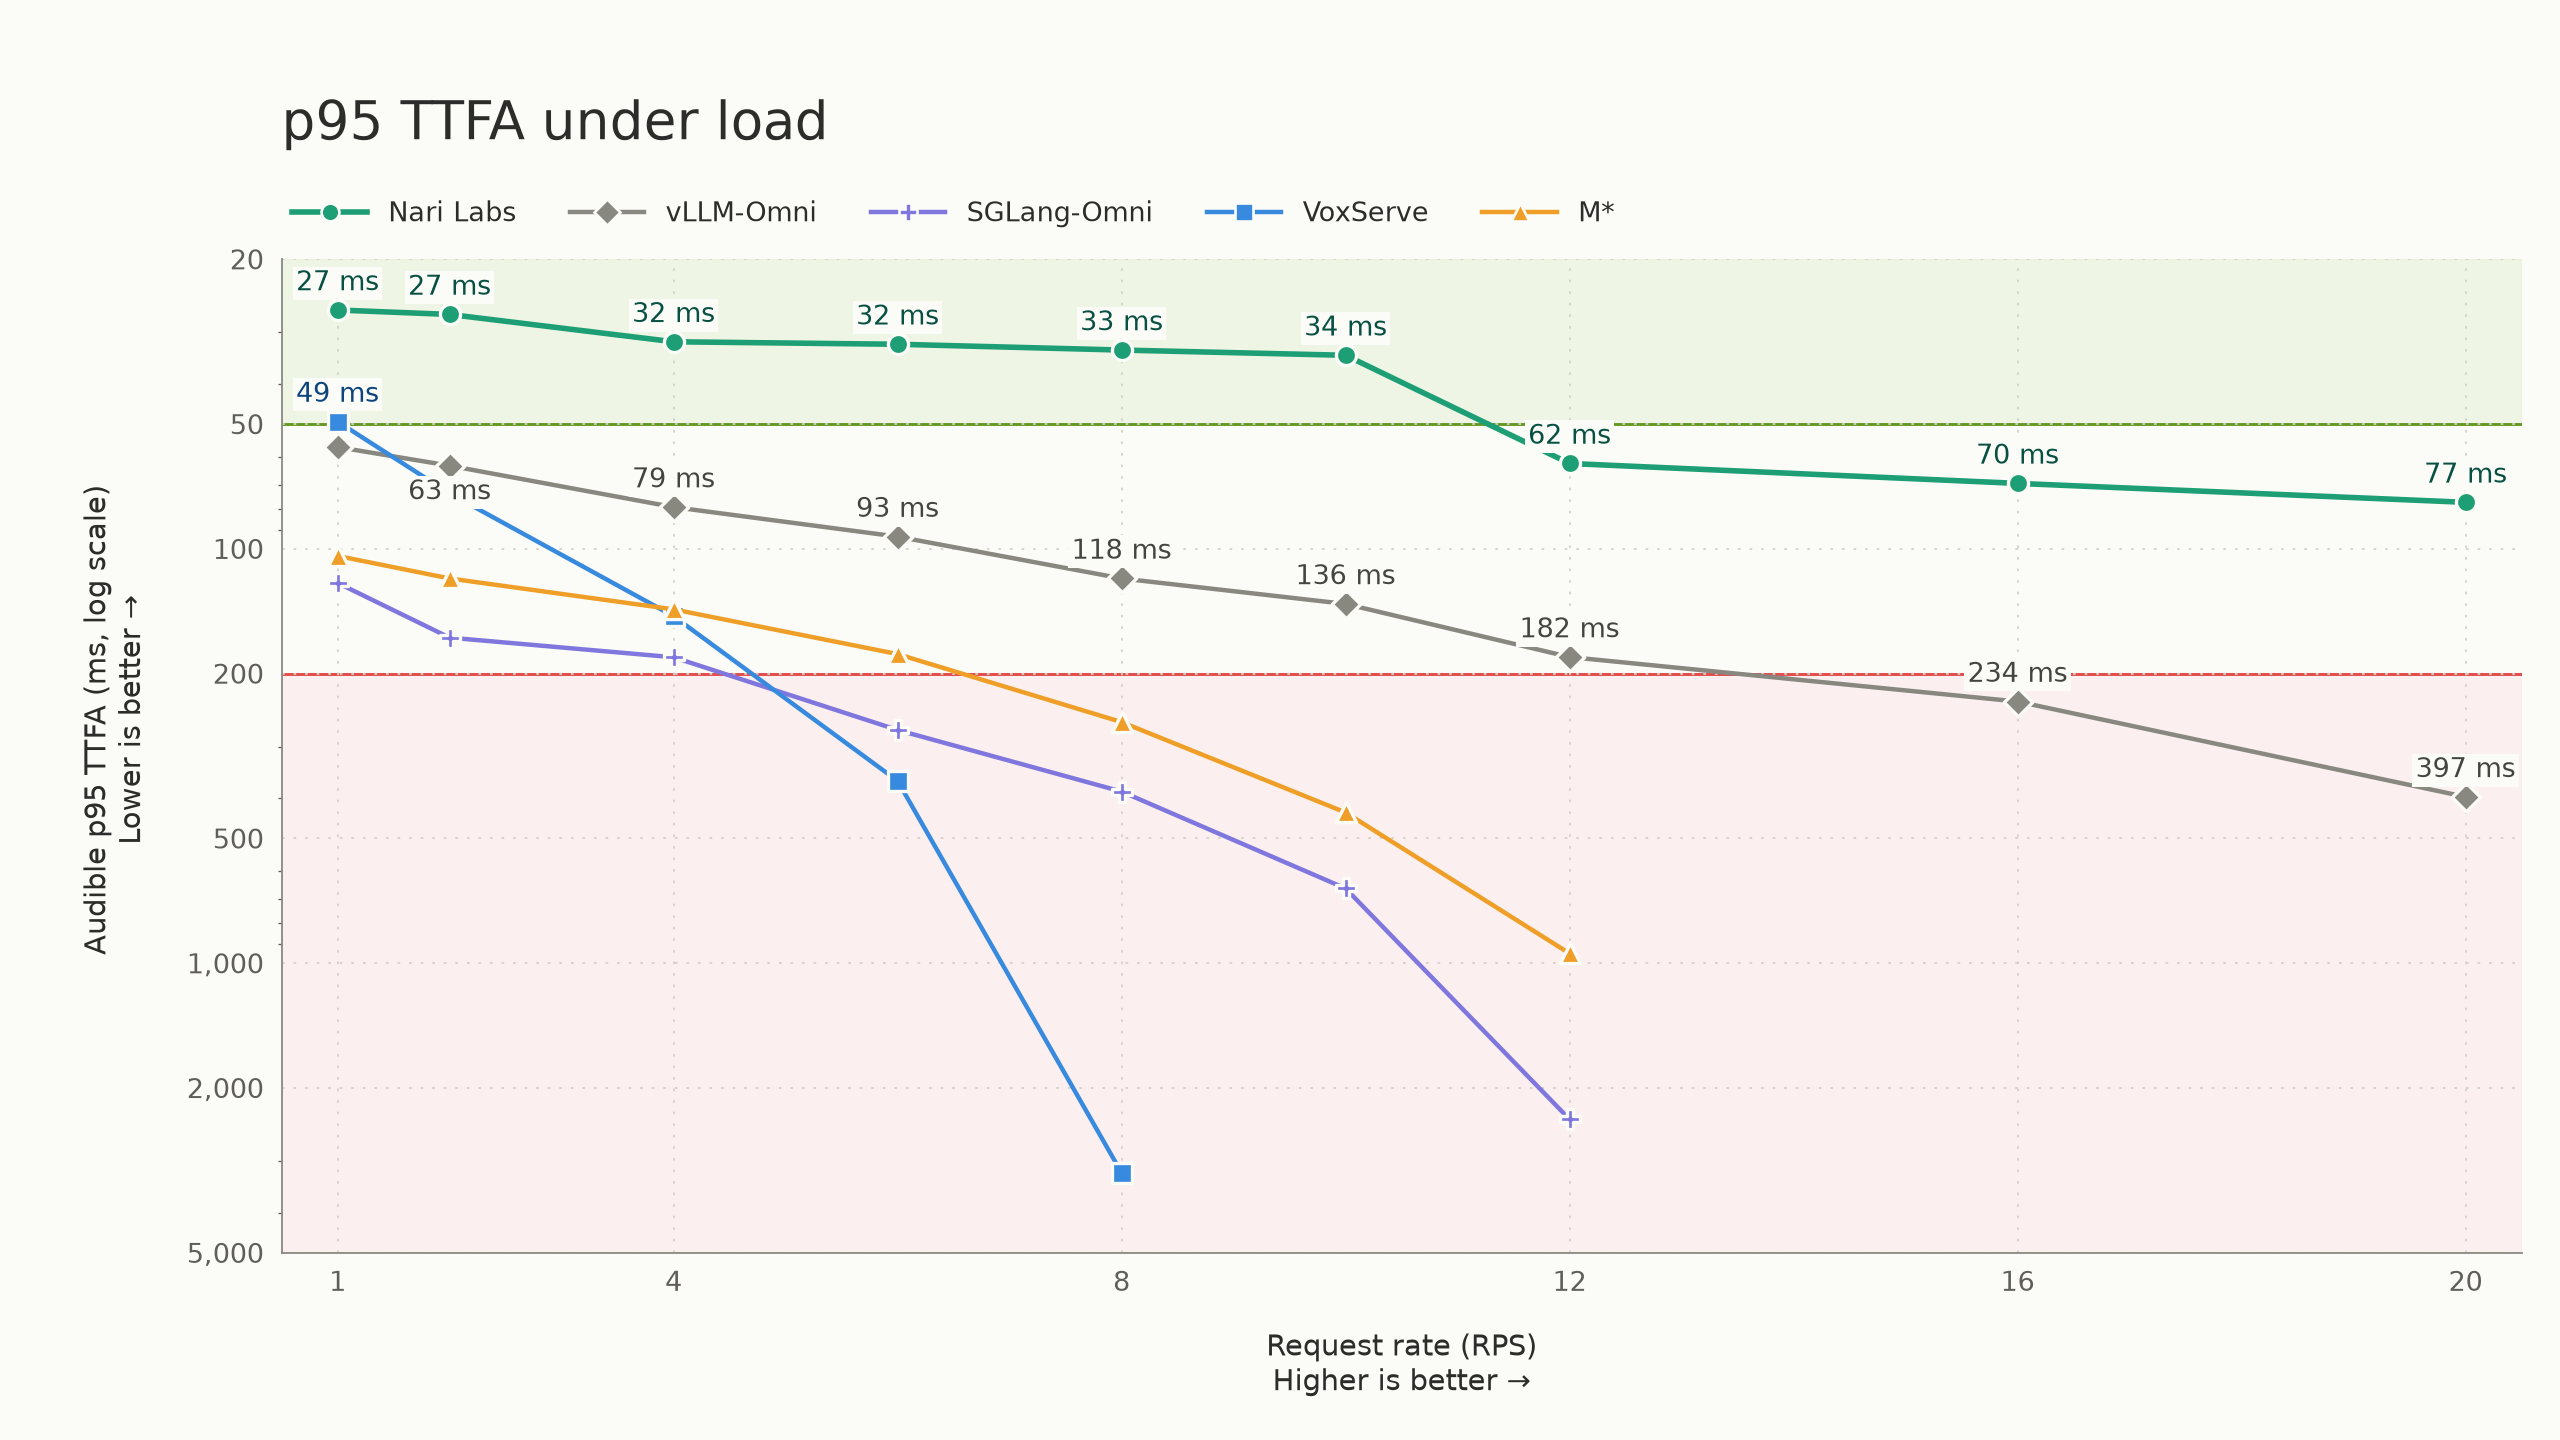
開發團隊開源 Qwen3-TTS 1.7B CustomVoice 實作與評測基準。在單張 NVIDIA H100 SXM 上,該系統達成 10 RPS(每秒請求數)且 p95 首音訊延遲(TTFA)低於 50 毫秒,並維持零緩衝區不足(underruns)的即時播放;在 20 RPS 時延遲仍低於 100 毫秒。開發團隊於 Reddit 補充,透過調整設定,在 RTX 4090 上也能達到約 50 毫秒的 p95 TTFA。
系統在 10 RPS 時每秒生成約 630 字元,以 H100 SXM 實例每小時 4.29 美元計算,滿載時每 100 萬字元成本約 2 美元(作為對比,ElevenLabs V3 為 100 美元,Cartesia Sonic 3.5 為 49 美元)。模型底層採用了自主研發的 Qwen3-TTS-Tokenizer-12Hz 來達成高效率的聲學壓縮。
在架構優化上,團隊將 Qwen3-TTS 的 Talker、Code Predictor 與 Codec 三個模組拆分為獨立可排程任務,交由單一排程器管理,根據播放期限等急迫性動態安排工作,而非採用傳統的兩階段固定執行順序。此外,系統加入動態修剪功能,透過短 RMS 視窗偵測語音並移除前端靜音,將 TTFA 改善約 80 毫秒,並動態調整音訊幀累積區塊大小(初始區塊小以降低延遲,後續區塊大以確保連續播放)。
在 5 分鐘 Poisson open-loop 流量測試中,經前端靜音與幀累積調校後,1 RPS 時僅 VoxServe 達成低於 50 毫秒延遲(49.3ms),vLLM-Omni 為 56.8ms,SGLang-Omni△ 與 M* 皆破百;而在 6 RPS 時,所有競品引擎的 p95 TTFA 皆升至 93 毫秒至 363 毫秒不等,僅該開源實作能維持低延遲。
讀原始報導背景
Qwen3-TTS 是一個開源的語音生成模型系列。在即時語音生成(Real-time TTS)應用中,系統必須在極短時間內產出首段音訊並確保播放不中斷,這對伺服器的推論延遲與吞吐量是一大挑戰。
社群討論
開發者將 qwen3-tts 優化至在單張 H100 達成 34 ms p95 TTFA(10 req/s),並證實在 RTX 4090 上也能以 50 ms 處理 10 個併發請求。然而社群提醒,低於人類聽覺處理時間(約 200ms)的極速回應會顯得不自然或像在打斷對話,且極限降遲往往會面臨音質下降的硬傷。此外,網友指出 LLM 推理(TTFT)才是實際應用的最大瓶頸,並期盼未來能實現低成本的手機端部署。
來源
- Reddit r/LocalLLaMAreddit.com
- github.com