模型發布
智譜 CEO 揭露 GLM-5.3 依賴全合成環境 RL 提升推理,開源模型 Ornith-1.5 釋出 397B MoE 版本
Latent Space單一來源
尚未逐項核實
目前依單一來源整理,這是來源數量描述,不是對消息真假的判定。
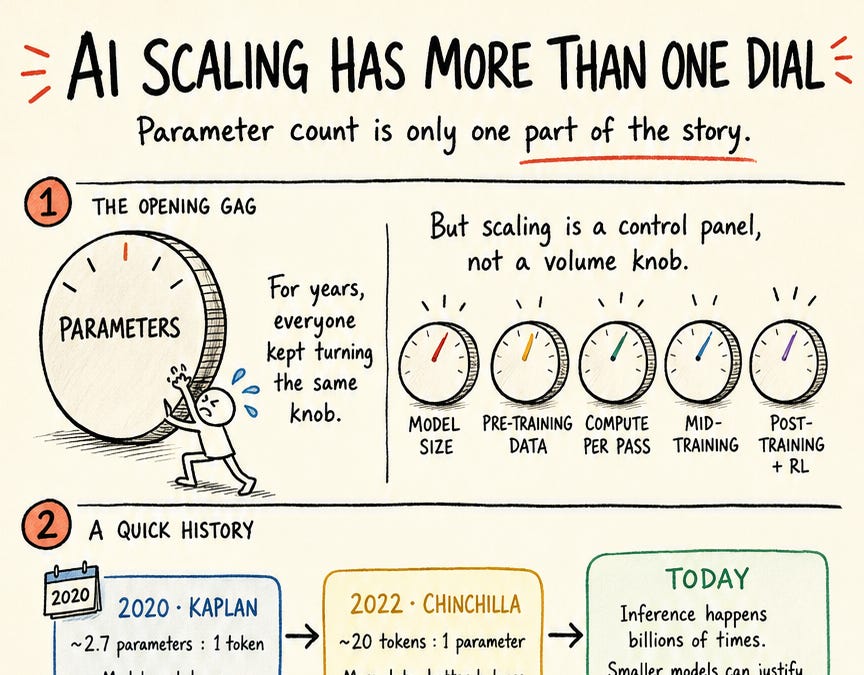
據 Latent Space 報導,智譜 AI(Z.ai)CEO 唐杰指出,評估模型不能僅看參數量,還需考量資料量、算力分配與部署條件。他表示記憶能力依賴參數量,但推理能力取決於後訓練(post-training)資料與有效深度。GLM-5.3 的效能躍升完全來自長週期環境的強化學習(RL)。這些環境涵蓋工程與研究的實際工作流程,例如讓模型在具備運算叢集、儲存系統與程式碼庫的環境中,花費相當於資深工程師數天的工作量來診斷瓶頸、實作最佳化並交付端到端加速。
隨著 AI 代理能力提升,後訓練的擴展難點從模型轉移至環境。GLM-5.3 的環境、評判與驗證流程已完全合成化:研究代理從實際工作中收集模式並轉為具備多步驟依賴的長週期環境;評判代理嘗試驗證任務可解性;驗證器則在無參考解答下合成,通過 oracle、no-op 與未解決狀態檢查後,產生可靠的二元獎勵訊號供直接訓練。唐杰提出包含 MoE 稀疏性(XA-YB 表示法)在內的 5 個擴展控制項,並強調進階技能需要維持 20 步以上的長因果推論鏈,一旦達到特定知識閾值,該能力就不再取決於總參數量。
同期,開源模型 Ornith-1.5 依 MIT 授權發布 9B 密集、35B MoE 與 397B MoE 版本,支援 FP8、GGUF、MLX 與 NVFP4 量化格式。官方宣稱該模型具備端到端自我改進能力,可自行提出任務並產生 RL 經驗。其在 Terminal-Bench 2.1 取得 86.1 分,SWE-Bench Verified 取得 86 分,DeepSWE 取得 56 分,並已獲 vLLM 與 Ollama 支援。
在模型壓縮方面,UnslothAI 發布基於 Dynamic V3 的 Qwen3.8-27B GGUF 版本,宣稱在同等體積下準確率提升約 10%,其 1-bit 量化版在 8GB 記憶體下仍保留約 77% 的 BF16 準確率,並引入 Divergence-300 新指標來衡量長生成的貪婪準確率。
評測榜單方面,Agent Arena 由 Claude Opus 5 領先,Kimi K3、GLM 5.2、Grok 4.5 與 GPT-5.6 Luna 則定義了高性價比區間。Grok 4.6 在 Legal Research Bench 以 48.1% 排名第三,支援 500k 脈絡與工具呼叫;GLM 5.3 在開源模型中位列 Terminal Bench 第二與 Legal Bench 第三。此外,DeepSeek Harness(DSH)被揭露為基於 Cordis 外掛架構的輕量化設計,將代理迴圈等所有元件外掛化,Beta 用戶首週已部署逾百個外掛,包含連接即時資料庫執行 SQL 的代理。
讀原始報導背景
過去 AI 領域常以「Chinchilla 擴展定律」中訓練 token 與模型參數量的最佳比例來衡量模型發展。然而,業界目前正轉向「訓練後擴展定律(Post-training Scaling Law)」,強調透過微調、強化學習與合成資料增強等技術,進一步提升預訓練模型的準確度與運算效率。