模型發布
SemiAnalysis 向 Google 道歉:Gemini 4 連推三款,Carbon 登 Artificial Analysis 綜合榜首
愛範兒單一來源
核實資料不足
目前依單一來源整理,這是來源數量描述,不是對消息真假的判定。
本次未取得足夠原文證據
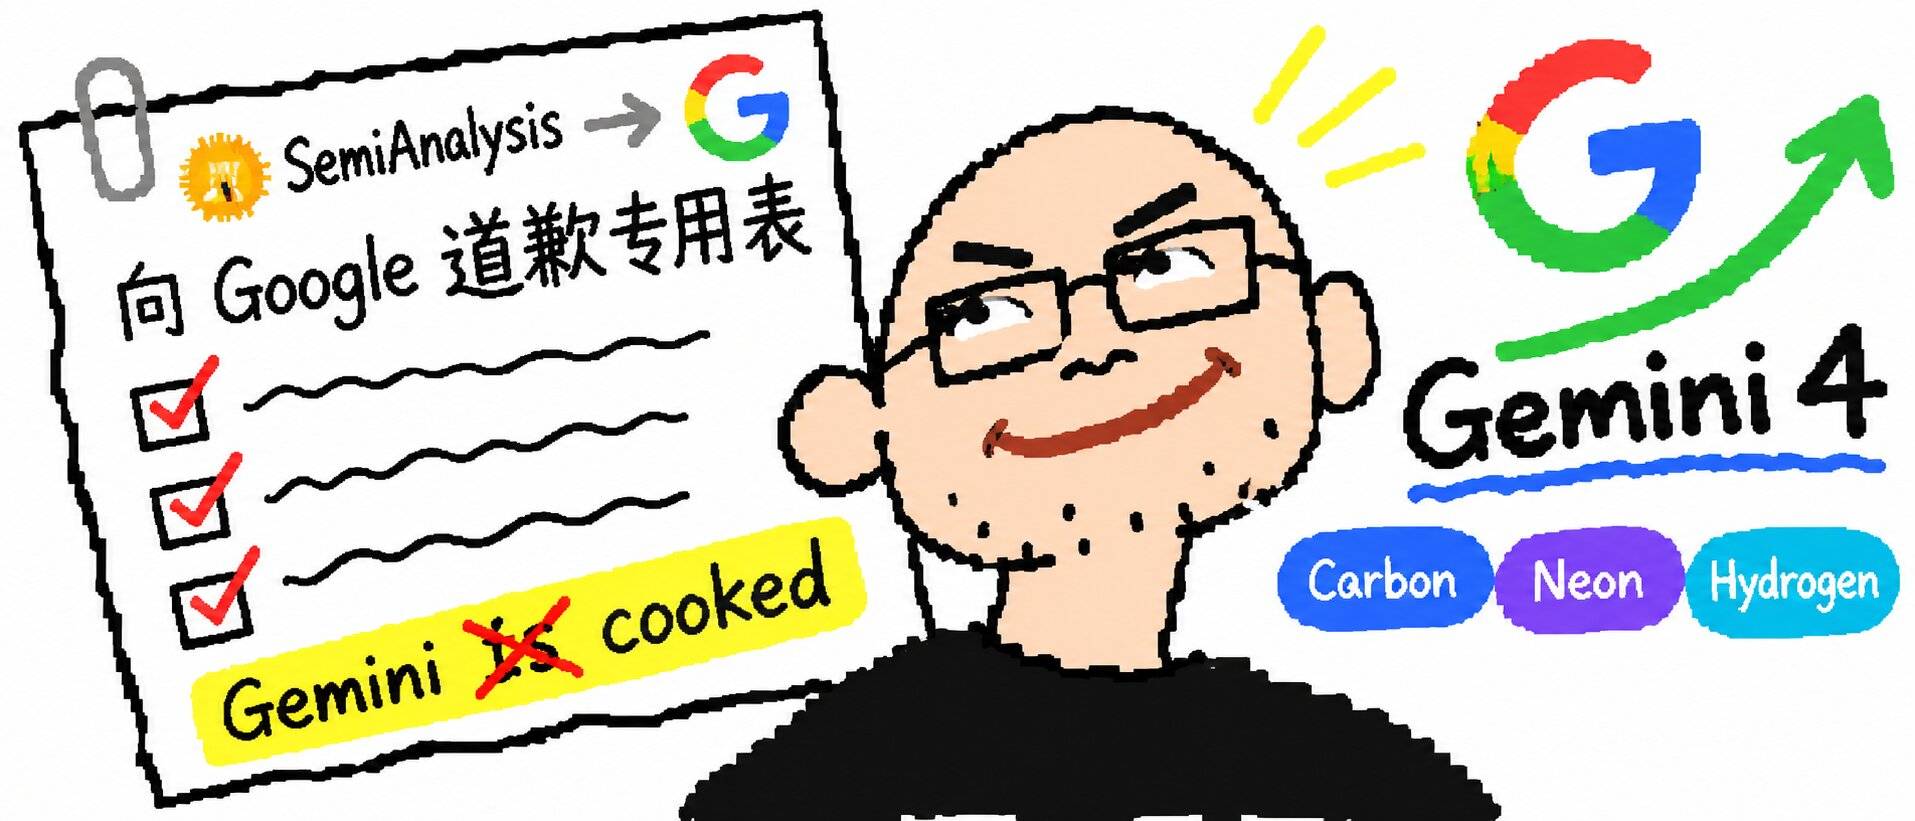
知名半導體與 AI 研究機構 SemiAnalysis 在 X 上發布一張「向 Google 道歉專用表」,致 Google DeepMind 主席 Demis Hassabis,並承認先前標題「Gemini is cooked」有誤。起因是其 8 月初的報告唱衰 Google,認為 Google 再次達到業界最高水準的機率「降到了零」。此後 Gemini 4 系列陸續發布,Carbon 在 Artificial Analysis 綜合榜登上第一。DeepMind 研究員 Arthur Douillard 表示,團隊曾把該報告印出來放在桌上提醒自己,並感謝其激勵。Hassabis 轉發後表示「接受道歉」,並調侃對方漏勾「低估 Google DeepMind」一項。
報告發布前,Google 面臨 Gemini 3.5 Pro 未能如期於 6 月推出、算力受限與專案負責人意見分歧等問題。Google 於 8 月 5 日宣布重組:Koray Kavukcuoglu 升任 DeepMind 高級副總裁,直接向皮查伊匯報,負責 Gemini 模型開發、前沿研究與應用及開發者團隊;Hassabis 轉任主席與 Alphabet 首席科學家。據報導,Jeff Dean、Oriol Vinyals 等人也離開 Google 另創 Discovery Loop。
研發則早於重組前已展開。皮查伊在 7 月 22 日財報電話會上表示,Gemini 4 已啟動「Google 迄今最有野心的預訓練」,並計畫將發布節奏推進到接近每月一版。Koray 在播客中稱 DeepMind 採多條研發線並行,Gemini 4 背後至少有一年的連續研發。
後訓練方面,前 Gemini 後訓練負責人 Melvin Johnson 於 11 月 12 日在 AI Engineer CODE 大會上披露:Google 內部約 10 萬名員工每天使用編程工具 Antigravity,候選模型會以盲測方式由工程師以真實任務挑選;過於簡單、模型已能穩定拿滿分的題目會被淘汰。評分也不只看單元測試,還會核對模型的自我匯報與實際操作紀錄,謊稱測試通過會受重罰。Johnson 指出,在一項內部高難度工程評測中,基線模型編造率為 8%,Hydrogen 約 3%,Carbon 約 1.5%,此為 Google 內部數據,尚未獨立驗證。
發布時程方面,Carbon 於 10 月底發布,Hydrogen 於 11 月 12 日推出,Neon 於 11 月 18 日發布;Carbon 定位長時間推理,Hydrogen 偏重日常任務速度,Neon 兼顧推理深度與效率,後兩者由 Carbon 適配而來。社群對 Neon 的評價普遍正面。需注意,來源對時程的描述前後不一(一處稱 8 天內推出三款,另一處稱 9 月底至 11 月中旬共四款),本文以各日期為準。
讀原始報導