研究與評測
Together AI 發表持續編譯系統 TKCC,宣稱推論吞吐量最高提升 2.6 倍並刷新 InferenceX 低延遲紀錄
Together AI一手來源
核實資料不足
來源為發布方或研究資料;不代表所有主張已獲獨立核實。
本次未取得足夠原文證據
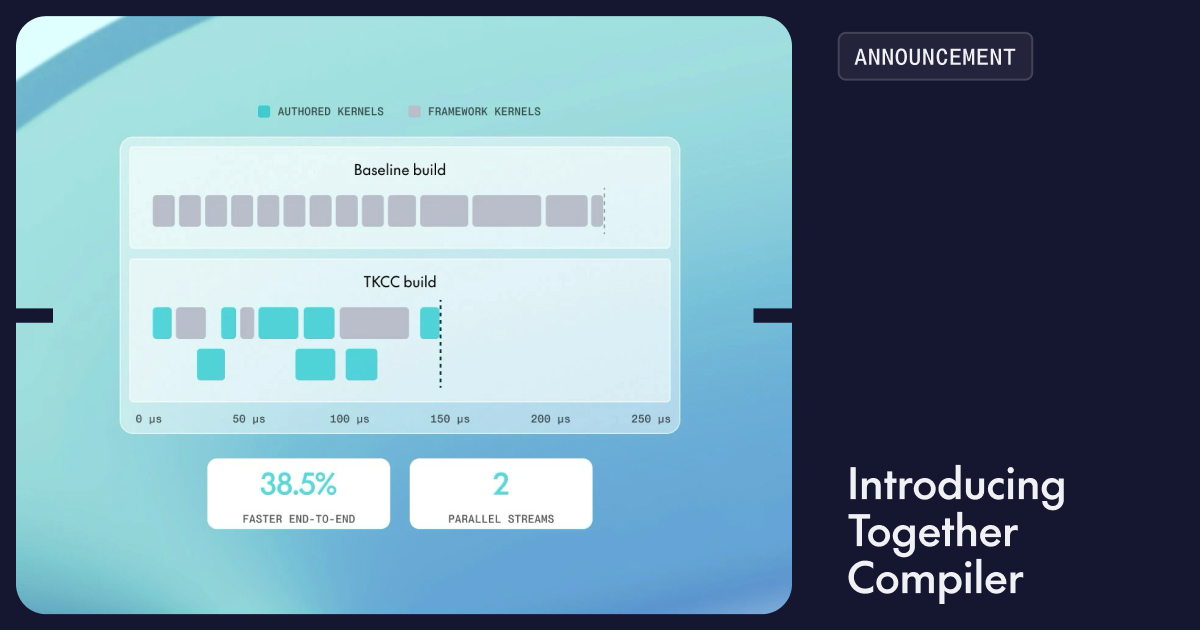
Together AI 發布名為 Together Compiler(TKCC)的持續最佳化系統,利用高吞吐量代理自動為推論工作負載尋找最佳化方案。據該公司表示,TKCC 在 24 小時內即可讓 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 等開源前沿模型的吞吐量(TPS)最高提升 2.6 倍。公司宣稱其在 SemiAnalysis InferenceX 低延遲基準上分別取得 MiniMax M3.1-Flash 1111 TPS、DeepSeek v4.1-Flash 1205 TPS 的成績,並在 Llama 1B、batch size 1 的設定下,較現有開源 megakernel 快 1.7 倍。公司亦稱該系統可延伸至語言模型以外的領域,包括天氣模擬、偏微分方程式、時間序列與生物學。
技術上,TKCC 採用三項設計:其一,「常駐引擎」(persistent engines)讓推論引擎只啟動一次,即可熱載入候選的前向傳播程式,避免每次實驗重啟引擎(傳統引擎啟動需數十分鐘);多個代理並透過留言板分享想法,以減少 GPU 閒置。其二,為兼顧量測速度與準確度,系統分為「快速引擎」(僅載入少數層,用於快速迭代)與「較慢引擎」(載入較多層,用於驗證最佳化在真實資料分布下是否成立)。其三,系統以自製成本模型選擇平行策略(如 TP、EP、DCP 等),結合硬體規格、微基準測試與實際前向傳播量測,以處理 MoE 專家不均衡等資料相關的流量特性。
公司另稱 TKCC 的實驗吞吐量是基線代理式效能最佳化系統的 252 倍,目前已用於服務數兆 token 的流量。以上數據皆來自 Together AI 自身發布的部落格文章,目前沒有其他來源佐證,獨立驗證尚待觀察。
讀原始報導