研究與評測
高通第一代 HBC 晶片完成驗證:記憶體頻寬較 LPDDR5X 提升 18 倍,AI250 明年上半年送樣
TechNews 科技新報單一來源
核實資料不足
目前依單一來源整理,這是來源數量描述,不是對消息真假的判定。
本次未取得足夠原文證據
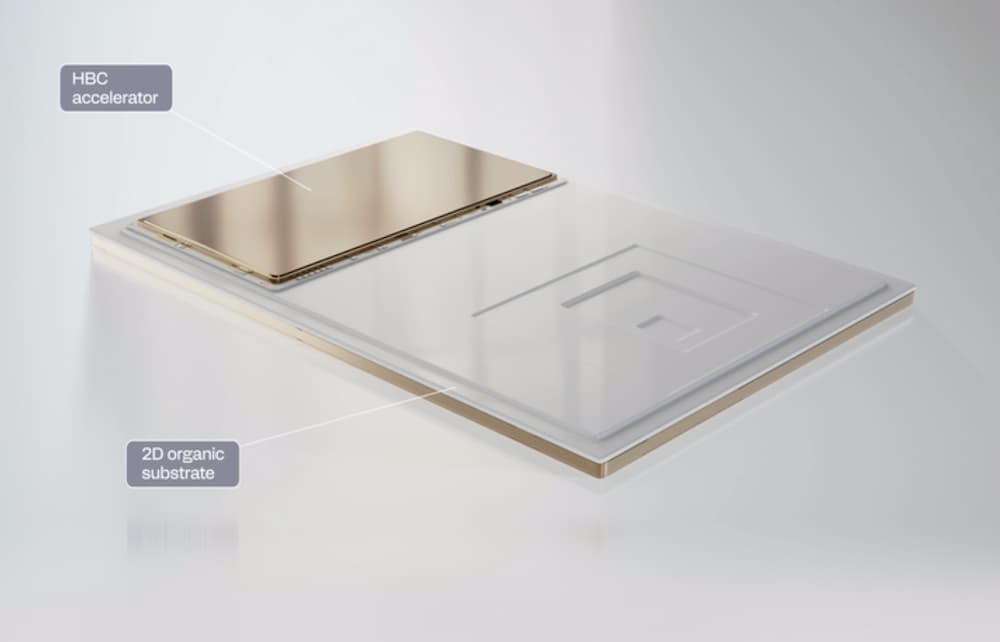
高通宣布已在美國聖地牙哥實驗室完成第一代高頻寬運算(HBC)晶片驗證。據其公布的硬體實測結果,在接近量產規格的尺寸條件下,HBC 相較採用 LPDDR5X 記憶體的實作方案,有效記憶體頻寬提升 18 倍;每瓦頻寬表現則超越 HBM4 逾 5 倍。
HBC 將低功耗 LPDDR 記憶體晶粒垂直堆疊在 AI 加速器基礎晶粒上方,並以晶圓對晶圓直接鍵合技術整合,把資料傳輸距離從毫米縮短至微米,使處理邏輯能在同一封裝內進行近記憶體運算(NMC),消除低算術強度運算的封裝外資料傳輸開銷。目前主流的 HBM 仍面臨散熱、成本與電力消耗問題,以 SRAM 為基礎的方案則受限於容量與整機櫃總持有成本(TCO)。
本次實驗室測試採用兩層 DRAM 堆疊於邏輯晶片上方,未來商用產品將採四層堆疊。高通表示,技術基礎包括逾十年的 3D 記憶體整合研究、JEDEC 標準制定與晶圓對晶圓鍵合經驗,並已將重新映射(Remapping)與冗餘(Redundancy)技術整合進製程,以降低堆疊矽晶層間的缺陷擴散風險。
高通計畫將 HBC 導入 Dragonfly AI 系列,首款 Dragonfly AI250 加速器平台將於明年上半年提供樣品,採液冷散熱,系統記憶體容量可達 38.6TB,有效記憶體頻寬達每秒 7.4 PB。此外,高通計畫於 2027 年推出首款伺服器 CPU「Dragonfly C1000」(採自研 Oryon 架構),並於 2028 年在下一代 Dragonfly AI300 平台導入新一代 HBC 整合技術。
注意:以上數據為高通公布之實驗室結果,目前僅有單一來源報導,尚未有獨立第三方驗證。
讀原始報導背景
近存計算(NMC)是讓運算盡量靠近記憶體進行的做法,目的是減少資料搬移的成本。根據搜尋結果中的一篇技術教學,Qwen-72B 等大模型在生成單一 token 時,計算利用率不足 5%,資料搬移的能耗則是計算能耗的 100 至 1000 倍,這正是業界所說的記憶體牆問題。