研究與評測
GPT-6 Astra 直接改寫 Qwen3.5-0.8B 權重,MATH-500 從 7.9% 提升至 48.1%
Hacker News綜合 3 家報導多家報導
核實資料不足
多個報導來源提及此事;未必是彼此獨立的證據。
本次未取得足夠原文證據
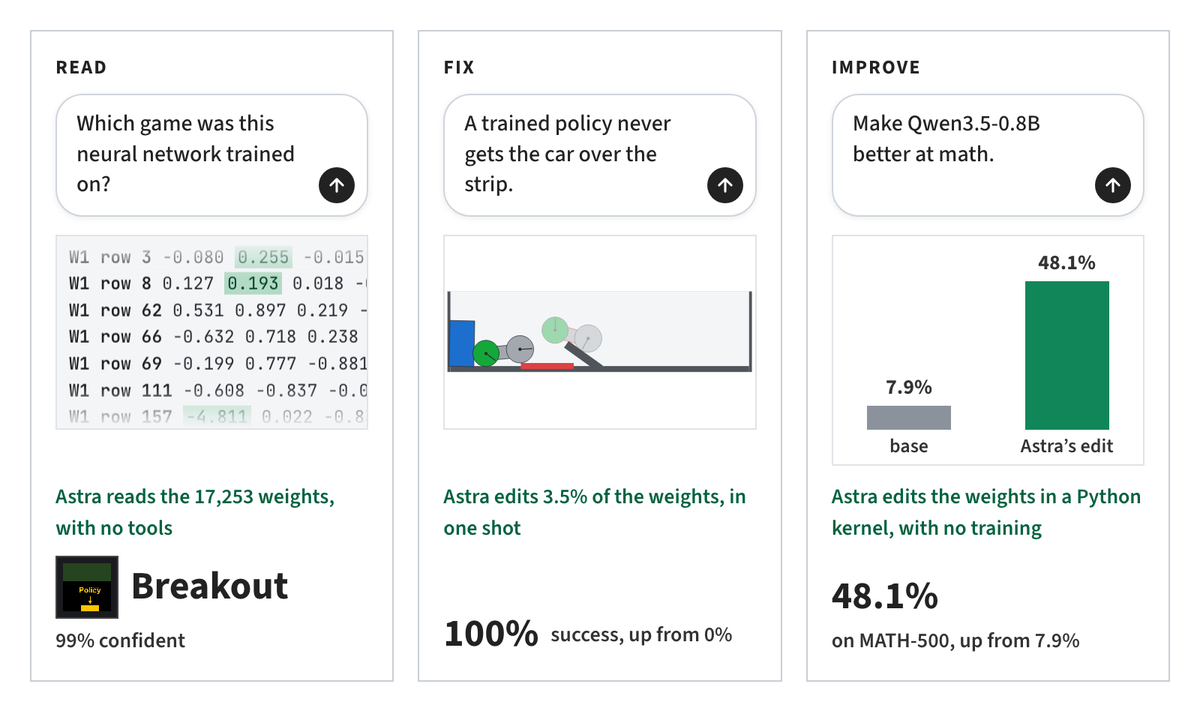
研究者 Rikiya Takehi 提出「權重空間程式設計」(Weight-Space Programming):前沿大型語言模型(LLM)可以直接閱讀與撰寫神經網路權重。據其部落格報告,GPT-6 Astra 僅看原始權重,就能判斷網路被訓練來做什麼;在沒有環境回饋的情況下,它能從零撰寫小型遊戲網路,表現優於以 PPO 訓練一億步的網路。
在 Qwen3.5-0.8B 的實驗中,Astra 在不使用梯度的前提下,找出權重中造成推理迴圈的問題(Qwen 模型卡本身也有提醒),並只修改了 0.016% 的權重。在相同取樣設定下,MATH-500 分數從 7.9% 提升到 48.1%,並可泛化到指令遵循,IFEval 提升約 3 倍。整個過程不允許 Astra 撰寫訓練迴圈,它是透過推理理解網路各部分的運算功能,再據此修改權重。
第二份來源(Reddit 貼文)與部落格數字一致:修改 0.016% 權重、數學提升最多約 6 倍(與 7.9% 到 48.1% 的比例相符)、指令遵循提升 3 倍。該貼文作者另表示,下一步是讓模型能自行編輯自身權重,但這屬於作者的展望,尚未有實驗結果。第三份來源(Techmeme)為轉載,內容未提供額外事實。
讀原始報導背景
文中提到的 Muon 是一種用於神經網路隱藏層的最佳化器,目前已用於 NanoGPT 與 CIFAR-10 的訓練速度紀錄挑戰。PPO(Proximal Policy Optimization)則是一種策略梯度(policy gradient)強化學習演算法,常用於策略網路很大的深度強化學習。
社群討論
討論整體驚訝與懷疑並存:多數人對 Astra 能直接讀寫小型模型權重、辨識網路功能並修正 Qwen 的循環問題感到震撼,也有人指出 Qwen 實測的 5 倍數學提升、3D 模型設計品質優於 Sol 等具體觀察。反方則認為實驗集中在 2 萬參數的小型 policy 網路與玩具任務,結果未必能推廣,且 Astra 只能把模型提升到自身水準,難以自我增強,RSI 疑慮因此被部分人視為誇大。
來源
- Reddit r/LocalLLaMAreddit.com
- Reddit r/MachineLearningreddit.com
- Reddit r/singularityreddit.com
- Techmemetechmeme.com
- kellerjordan.github.io
- en.wikipedia.org