研究與評測
Ubicloud 實測 vLLM 0.31 約束解碼:Kimi 與 DeepSeek 工具調用 Schema 準確率達 100%
Hacker News單一來源
尚未逐項核實
目前依單一來源整理,這是來源數量描述,不是對消息真假的判定。
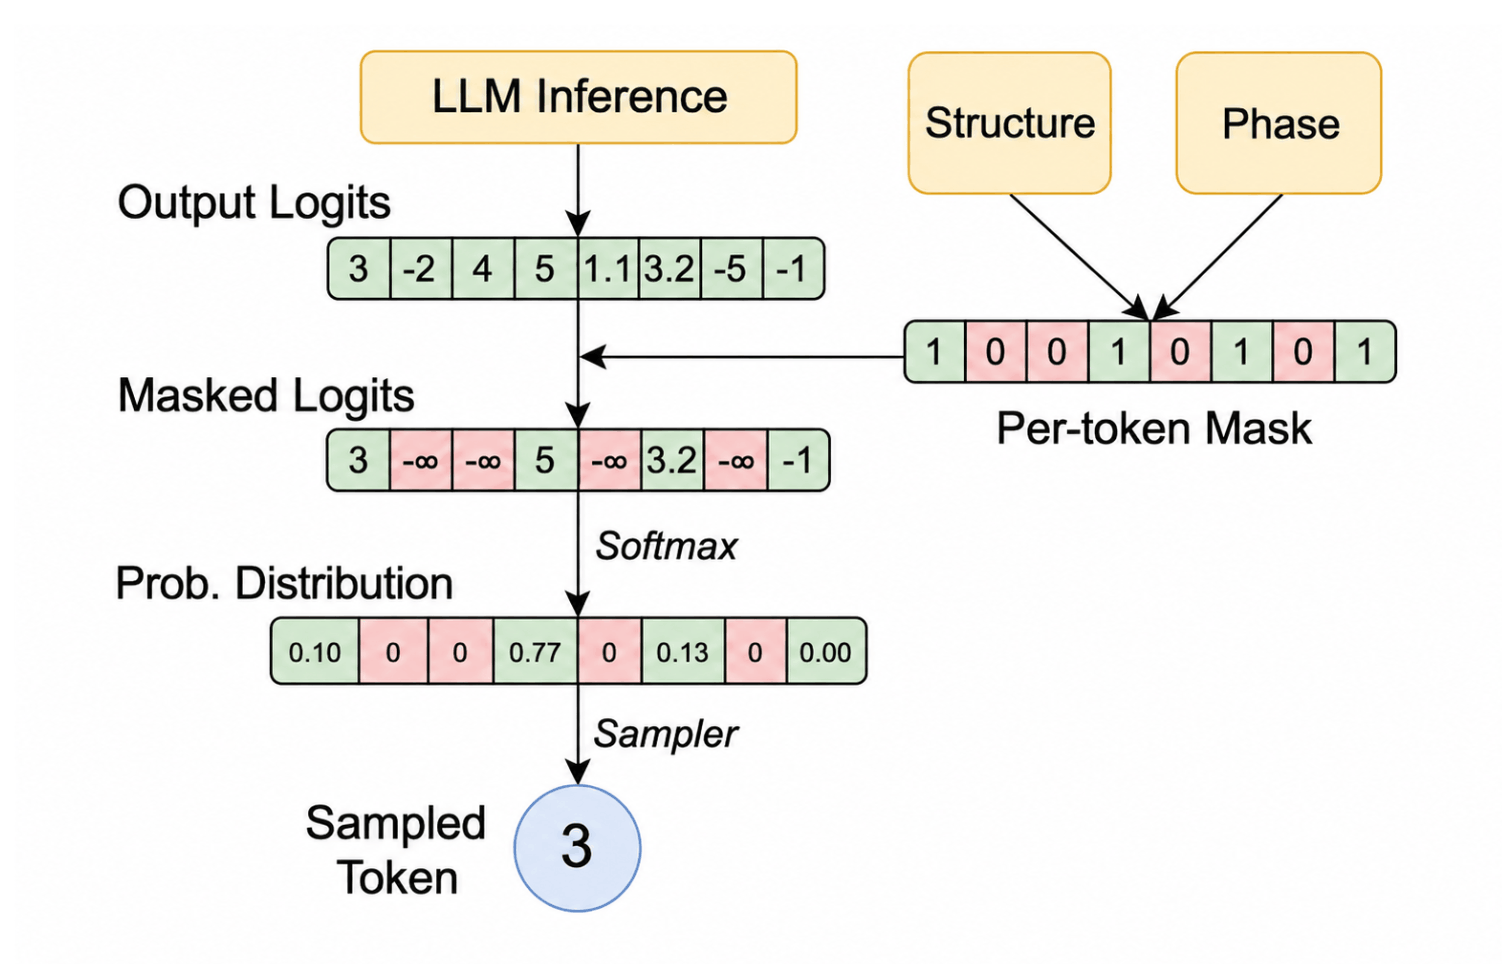
雲端基礎設施業者 Ubicloud 工程師撰文指出,在部署開源權重模型處理多輪 Agent 工作負載時,工具調用(tool call)輸出格式不符會導致上下文污染並增加重試成本。據其實測,以 vLLM 0.28 部署 Kimi K2.6 時,符合預期結構的 Schema 準確率僅 92%,相當於每 25 次調用就有 2 次失敗。
為解決格式偏移問題,vLLM 0.31 正式加入伺服端旗標支援「約束解碼」(constrained decoding)技術,透過在生成過程中強制模型符合 JSON Schema 定義。Ubicloud 測試顯示,開啟該旗標後,在較新的 Kimi 與 DeepSeek 模型上皆能達成 100% 的 Schema 準確率。
文章亦提及月之暗面(Moonshot AI)推出的 K2VV ToolCall 評測基準,該基準包含 2,000 個請求,專門以觸發相似度(trigger similarity)與 Schema 準確率兩項指標,檢驗推論引擎是否具備與原廠相符的調用表現。
讀原始報導背景
vLLM 是最初由加州大學柏克萊分校 Sky Computing Lab 開發的開源大型語言模型推論與部署軟體框架,核心採用專為 Transformer KV 快取設計的 PagedAttention 記憶體管理技術。而在大型語言模型推論領域中,constrained decoding 則是一種在生成過程中強制模型輸出遵循特定語法架構的技術,用以提升生成內容的可控性與可靠度。
社群討論
社群強調 100% 的 tool call 準確率對 Agent 至關重要,數據顯示若成功率僅 95%,連續執行 50 次調用時完全無錯的機率僅約 8%(先前 vLLM 運行 Kimi K2.6 僅達 92%),這也是單次需要約 300 次調用的開發者長期難以脫離 OpenAI 與 Anthropic 的主因。部分留言質疑該文更多是在解決 vLLM 繁雜的設定變更而非系統修復(作者則澄清最新版已可透過 `--tool-strict-level` 參數處理),同時亦有開發者擔憂 constrained decoding 會改變輸出分佈而影響模型品質,未必優於僅多耗費約 9% token 的重試方案。