研究與評測
Meta 揭露 Prometheus 叢集設計:超過 11% GPU 為備援或損壞,中斷次數一年降 99%
科技新報 AI單一來源
核實資料不足
目前依單一來源整理,這是來源數量描述,不是對消息真假的判定。
本次未取得足夠原文證據
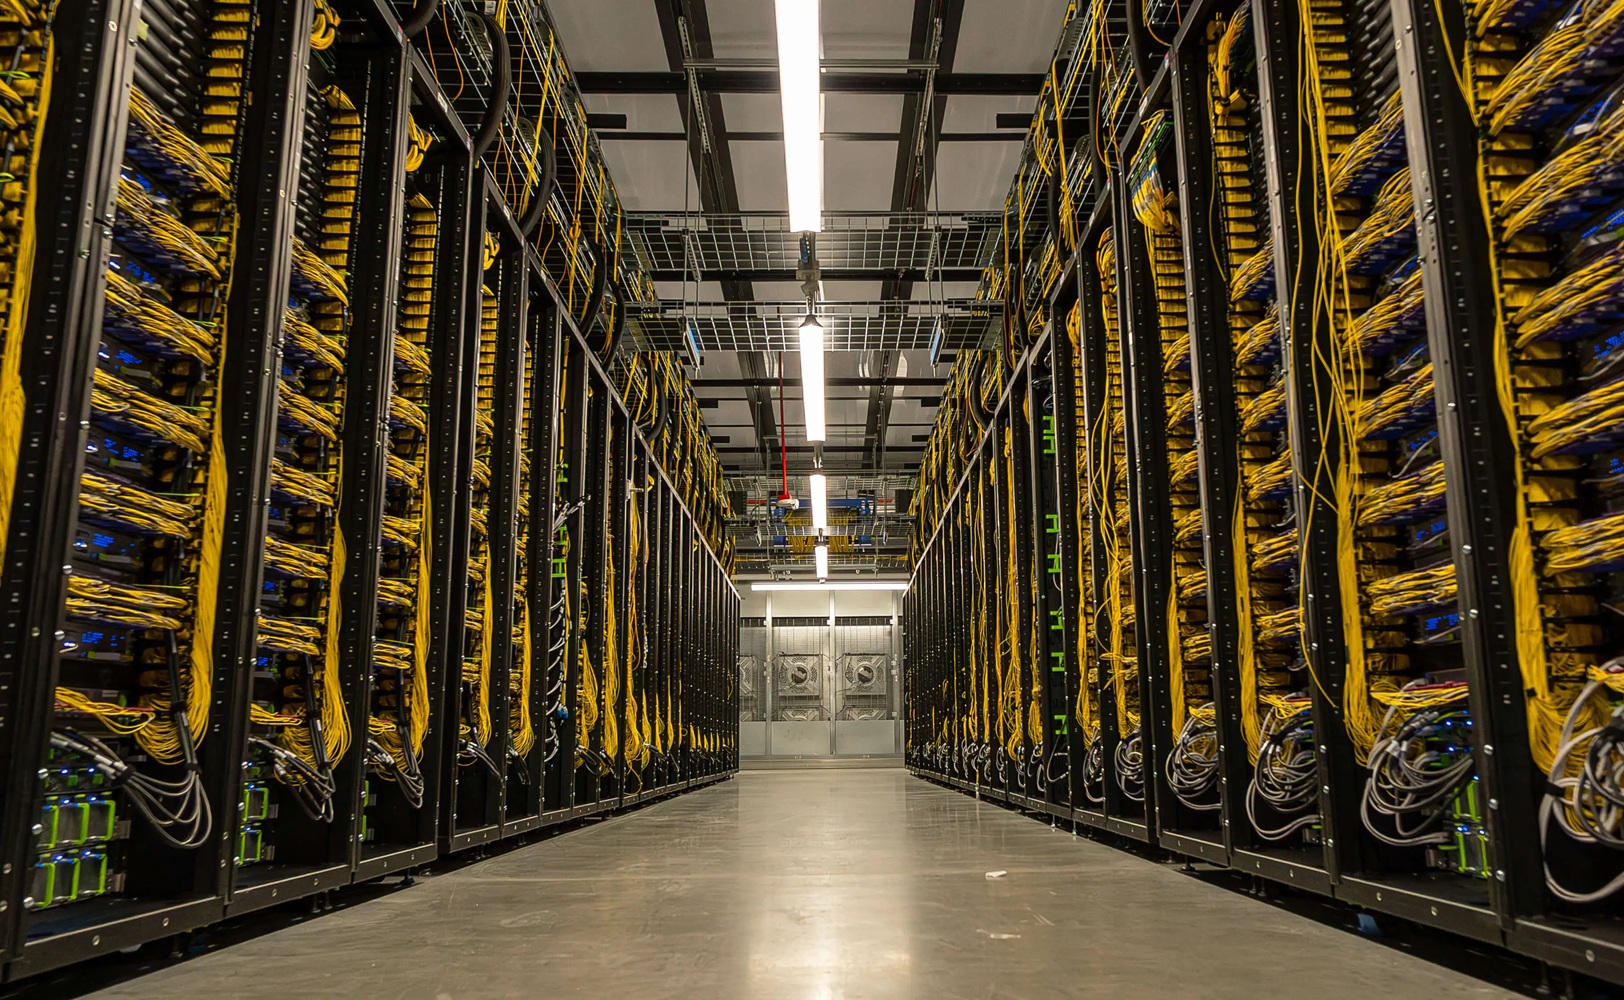
Meta 於 20 日揭露位於美國俄亥俄州新奧爾巴尼的 Prometheus 超級叢集運作細節,顯示為維持大型模型訓練不中斷,已投入相當可觀的備援成本。據報導,目前 Prometheus 超過 11% 的 GPU 不是已損壞,就是留作可隨時接手的閒置備援。
Prometheus 採用 Nvidia GB200 / GB300 系統,每個 NVLink 域共 72 顆 GPU,訓練時實際動用 64 顆,其餘 8 顆為熱備援。Meta 表示,單一 GPU 故障可能拖垮整個機櫃,備援可立即補位,避免整櫃退出集群,縮短中斷時間。
在機櫃層級之上,Meta 另有部署層級的容錯機制:故障若可限制在資料並行的單一模型副本內,系統會讓該副本下線,其餘繼續訓練;若範圍更大,則透過分散式檢查點將模型狀態異步保存到多層儲存,避免從頭重跑。Meta 將此設計比喻為自動儲存與版本回溯,目的是把可能導致整體停擺的事件降為短暫吞吐量下降。
擴張過程中,Prometheus 的訊號與網路挑戰也相當嚴峻。系統內有超過 60 萬條 NVLink 連線,任何輕微訊號劣化都可能觸發恢復流程,因此 Meta 導入持續遙測與 L11 診斷測試,部署前先找出弱鏈路。電力方面,Meta 以軟體 Dynamo Dimmer 逐步調整 GPU 功耗,避免電力尖峰造成訓練被迫中止。
據 Meta 表示,經過一年工程調整,Prometheus 的訓練中斷次數較 2025 年中期下降 99%,由每 8 千顆 GPU 每日近千次降至約 11 次。目標是將中斷率進一步壓到每 8 千顆 GPU 每日約兩次,約等於 10 萬 GPU 小時才中斷一次。(圖片來源:Meta)
讀原始報導背景
NVLink 與 NVLink Switch 是 NVIDIA 的資料中心高速互連技術,兩者搭配可提升 AI 運算效能並有效擴展系統規模。本則報導中的 NVLink 域即屬於這類互連架構。