研究與評測
Nick Cammarata 發表長文推翻神經網路多義性假說:藉 Agent 分析證實視覺模型末層達 99% 可解釋
Latent Space綜合 2 家報導多家報導
核實資料不足
多個報導來源提及此事;未必是彼此獨立的證據。
查證回合用盡,未形成有依據結論
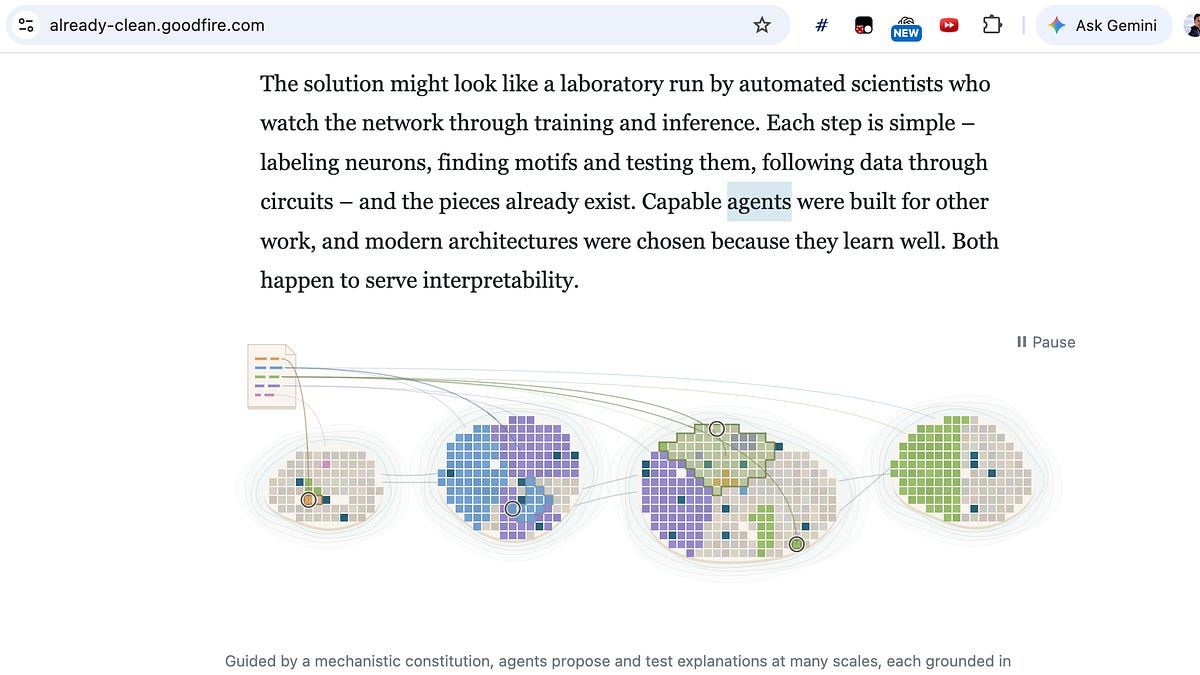
Goodfire 研究員 Nick Cammarata 發表長文《Neural Networks Are Already Clean》,提出神經網路內部具有高度連貫與精準邏輯,推翻學界長期認為權重存在糾纏「死結」的多義性(polysemanticity)與疊加(superposition)假說。Cammarata 曾任 OpenAI 早期機制可解釋性研究科學家,亦為論文《Zoom In》共同作者。他推翻自己十年前建立的經典案例——過去認為 InceptionV1 模型的「4e:55」神經元因同時被「貓臉」與「汽車車頭」強烈激活而不可解釋;新研究藉由 Agent 團隊與新演算法重新檢驗,證實該神經元實為檢測「V 字幾何形狀」(狐狸尖臉與火焰激活正極、圓形激活負極),並非無規律的多義特徵。這項發現對近年以稀疏自編碼器(SAE)為主流的特徵解纏拆解思路提出質疑。Cammarata 指出,2023 年他在 OpenAI 執行大規模自動化神經元解釋項目時,受限於觀測工具僅能解釋約 2% 的神經元;如今在 Agent 分析下,測試的現代視覺模型最後一層已有 99%~100% 的神經元取得清晰解釋,InceptionV1 的可解釋率也大幅提升,有助於降低 AI 安全評估中的 P(doom) 風險。
讀原始報導背景
在神經網路中,單個神經元往往會同時表徵多種不相關的特徵,這種現象被稱為多義性(Polysemanticity)。這類交錯的權重結構過去被認為難以直接被人理解,一直是模型可解釋性(Interpretability)與對齊研究中的核心難題。