開發生態
據報開發者最佳化 llama.cpp 的 prompt lookup decoding,草稿生成速度最高提升 140 倍
Hacker News單一來源
尚未逐項核實
目前依單一來源整理,這是來源數量描述,不是對消息真假的判定。
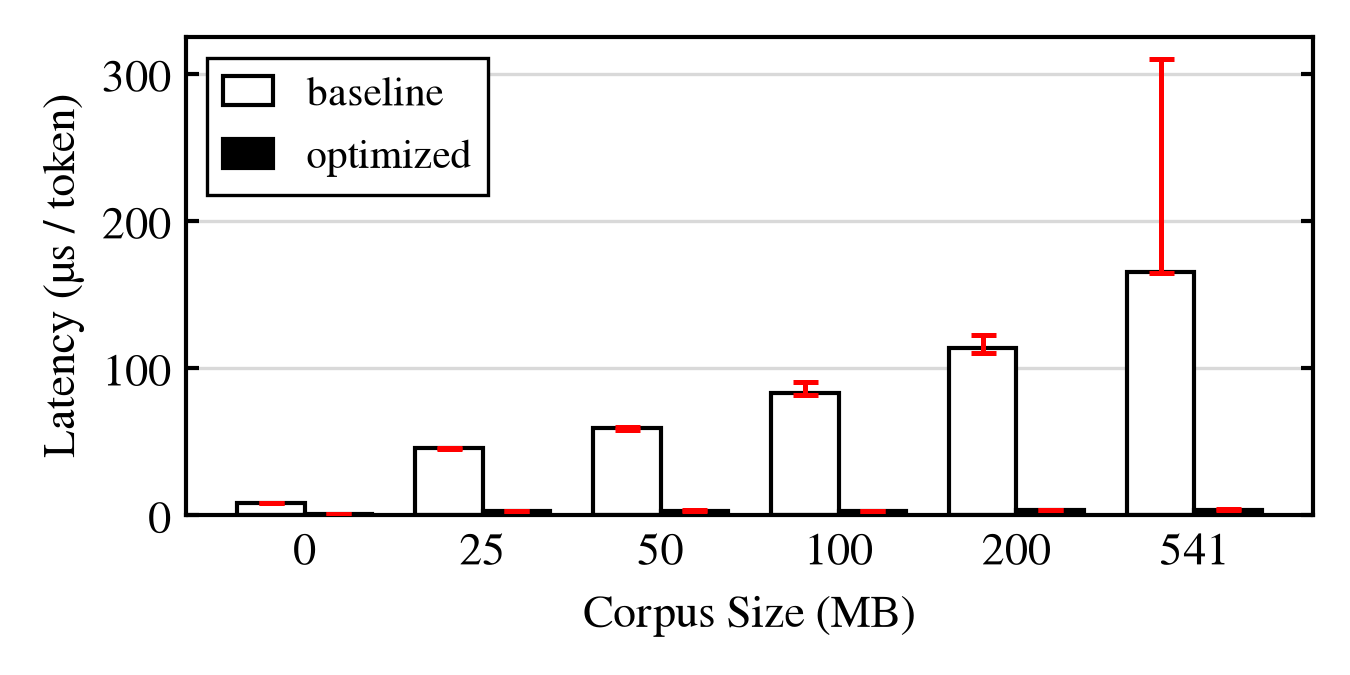
據開發者部落格文章指出,透過一系列效能最佳化,llama.cpp 中的 prompt lookup decoding(又稱 n-gram speculation)草稿生成速度獲得大幅提升。作者初步將生成速度提升達 42 倍,並減少最高 2.6 倍的記憶體佔用;隨後在整合 Daniel Lemire 提交的 PR(額外提升 4.2 倍速度)後,整體加速最高達 140 倍。
prompt lookup decoding 是一種使用簡易 n-gram 模型進行推測解碼(speculative decoding)的技術。llama.cpp 為此維護三種快取機制:儲存當前處理中 1 至 4-gram 的上下文快取(context cache)、儲存過往執行紀錄的動態快取(dynamic cache),以及透過 llama-lookup-create 工具從靜態語料庫建立的 2-gram 靜態快取(static cache)。
在草稿生成過程中,系統會依序使用上下文、動態與靜態快取為詞彙評分。當候選 token 的出現次數與頻率比例達到系統硬編碼的閾值(例如上下文快取的出現次數閾值為 2, 2, 1, 1,頻率比例為 0.66, 0.5, 0.5, 0.5)時,即被接受為草稿 token。作者的基準測試(benchmark)是採用 WikiText-103 語料庫建立靜態快取,並透過 llama-lookup-stats 工具模擬模型輸出以驗證效能。
讀原始報導社群討論
討論焦點主要圍繞貢獻者因意外標記維護者遭封鎖而無法發 PR 的社群爭議,部分網友批評維護者態度強硬,甚至直指 llama.cpp 程式碼品質不佳而建議直接硬分叉。儘管如此,技術面上仍有正面進展,原作者指出 Daniel Lemire 貢獻了進一步的最佳化,使效能獲得顯著提升。
這則事件的發展
本期分類