研究與評測
開發者以 SFT 與 RL 訓練 4B 模型最佳化 Postgres 查詢計畫,113 個複雜查詢延遲降低 44.7%
Hacker News單一來源
尚未逐項核實
目前依單一來源整理,這是來源數量描述,不是對消息真假的判定。
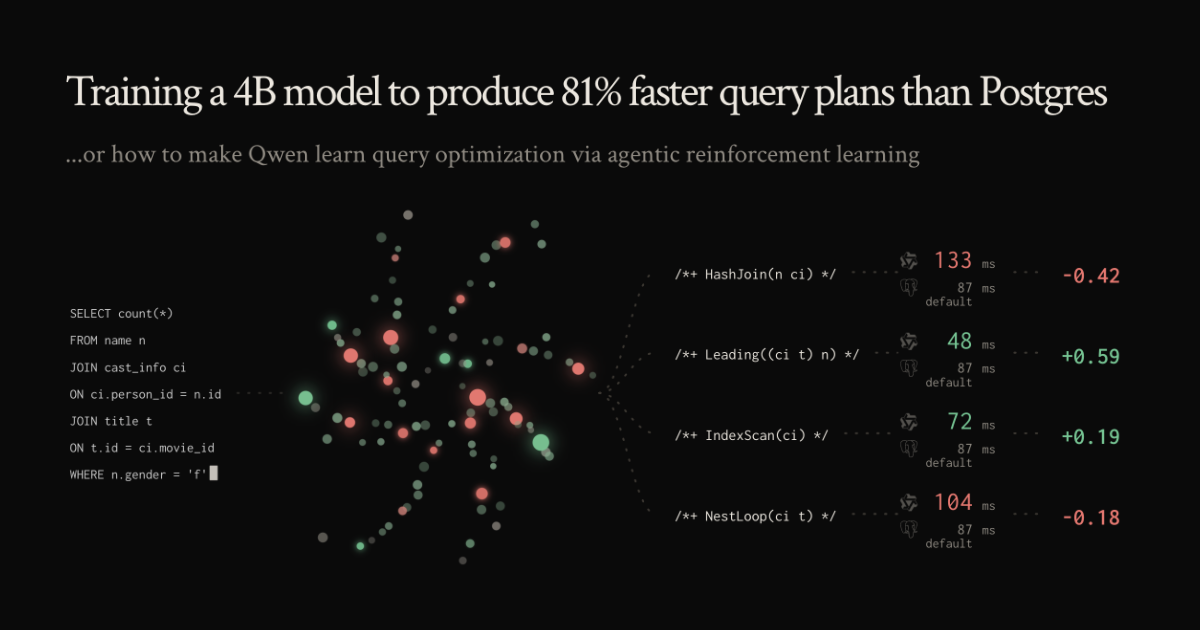
據報導,開發者透過監督式微調(SFT)與代理強化學習(RL),訓練一款 4B 開放權重模型以產生 Postgres 查詢計畫。實測顯示,該模型在 113 個大量使用 Join 的查詢中,達成 44.7% 的延遲降低(原文標題稱比 Postgres 預設快 81%),而該模型最初甚至無法為其中 99 個查詢產生計畫。
為克服單一最佳化目標(查詢執行時間)的環境雜訊,實驗設計了自訂的 GRPO 變體來為 RL rollouts 評分,並建構最小化 Linux 頁面快取競爭雜訊的 Postgres 測量環境。硬體部署將 RL 分散於兩處:租用的 2x H100 節點負責 vLLM 與訓練器,本地端則運行四個 Postgres 容器。此外,訓練過程還包含透過 500 條「GPT-6 Astra」代理軌跡進行的 off-policy 蒸餾。
讀原始報導社群討論
社群讚賞文章將 LLM 應用寫得淺顯易懂,作者耗費約 1200 美元(800 美元算力與 400 美元 API)訓練 4B 模型,在特定 SQL 負載下達到 1.81 倍加速並降低 44.7% 延遲。然而,多數人質疑其測試環境過於理想(8GB in-memory 資料集、唯讀 SELECT),且忽略了實際資料庫必須考量「規劃加執行」的總時間成本。許多開發者指出 LLM 缺乏確定性且容易產生幻覺,認為傳統機器學習或 AlphaGo 式的神經網路會是解決 query planning 更好的工具。