開發生態
數發部啟動「臺灣主權AI訓練語料庫」民間徵集,採無償授權、目前規模達 22 億 Tokens
數位發展部單一來源
尚未逐項核實
目前依單一來源整理,這是來源數量描述,不是對消息真假的判定。
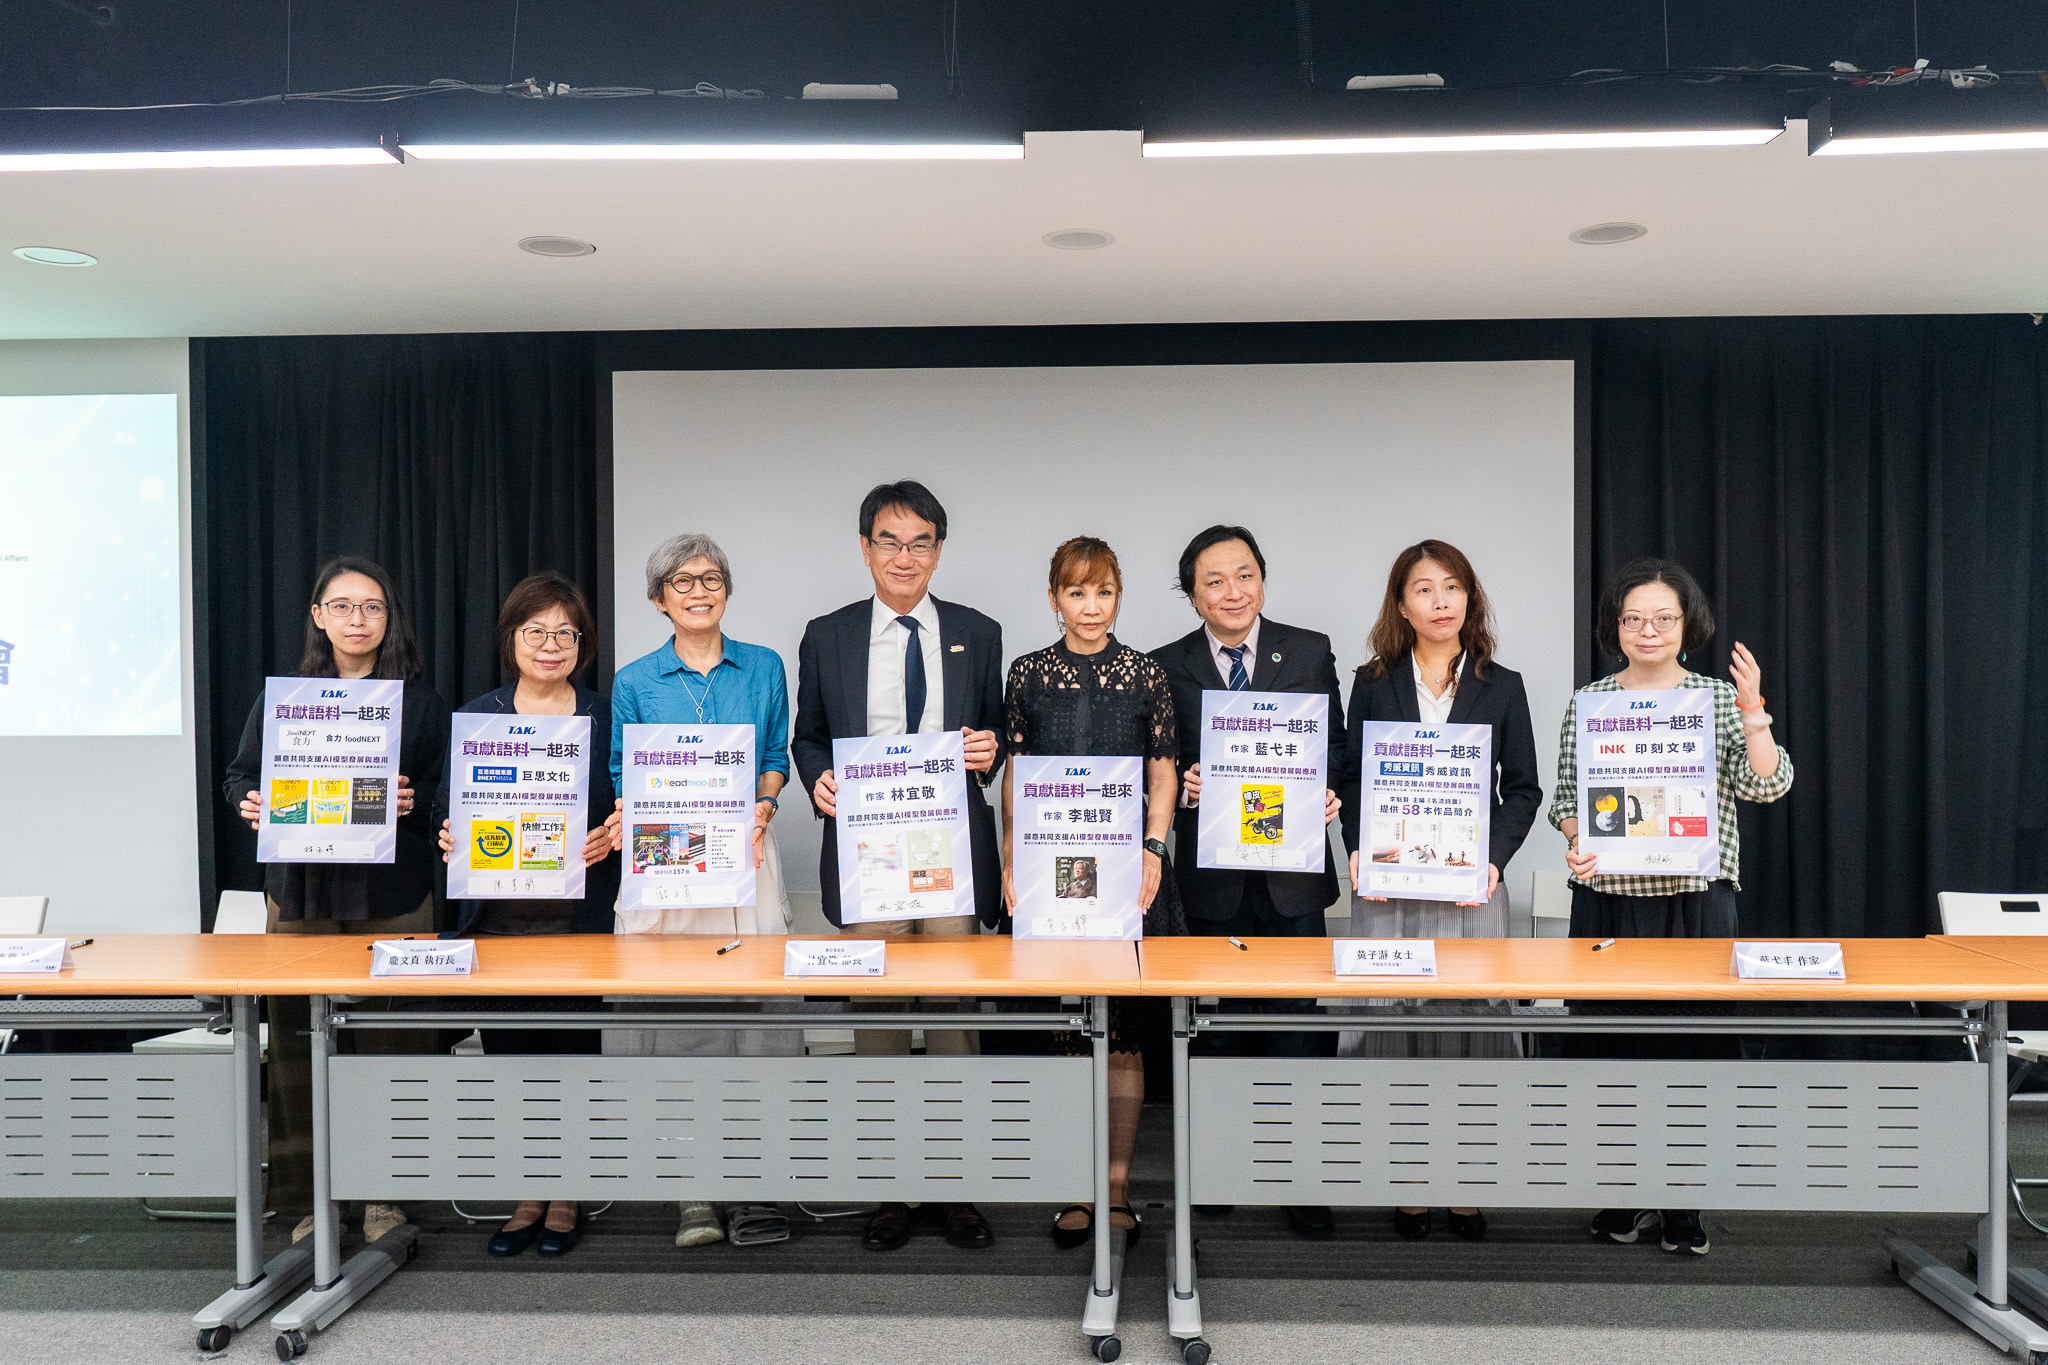
數位發展部宣布正式啟動「臺灣主權AI訓練語料庫」民間語料徵集行動,採無償授權方式向出版業及電子書平臺徵集內容,以降低國際大型語言模型偏重簡體中文的影響。該語料庫自去年底上線,初期以中央及地方政府語料為主,截至今年 8 月底規模已達約 22 億 Tokens。
本次重點徵集內容包含四大類:經同意授權之出版品、出版品簡介、出版品試閱內容,以及已逾著作權保護期間的公共財典籍。針對著作權爭議,數發部強調徵集採「自願參與、明確授權、可退出」三大原則,並設有下架申請管道。
目前已有 Readmoo 讀墨、印刻文學、秀威資訊、食力、巨思文化等多家業者及作家簽署授權同意書,數發部部長林宜敬亦捐出《幸福的鬼島》等個人著作響應。
讀原始報導背景
大型語言模型(LLM)通常基於 Transformer 架構,透過處理大量的文本 Token 來學習字詞間的關聯,進而具備生成、摘要與推理等自然語言處理能力。目前主流的 AI 聊天機器人如 ChatGPT、Claude 與 Gemini 皆是建立在此技術基礎上。