研究與評測
開發者實測推估前沿模型訓練時間線:GPT-5.6 基準點約為 2026 年 2 月,Opus 5 實際知識未達官方宣告
Hacker News單一來源
尚未逐項核實
目前依單一來源整理,這是來源數量描述,不是對消息真假的判定。
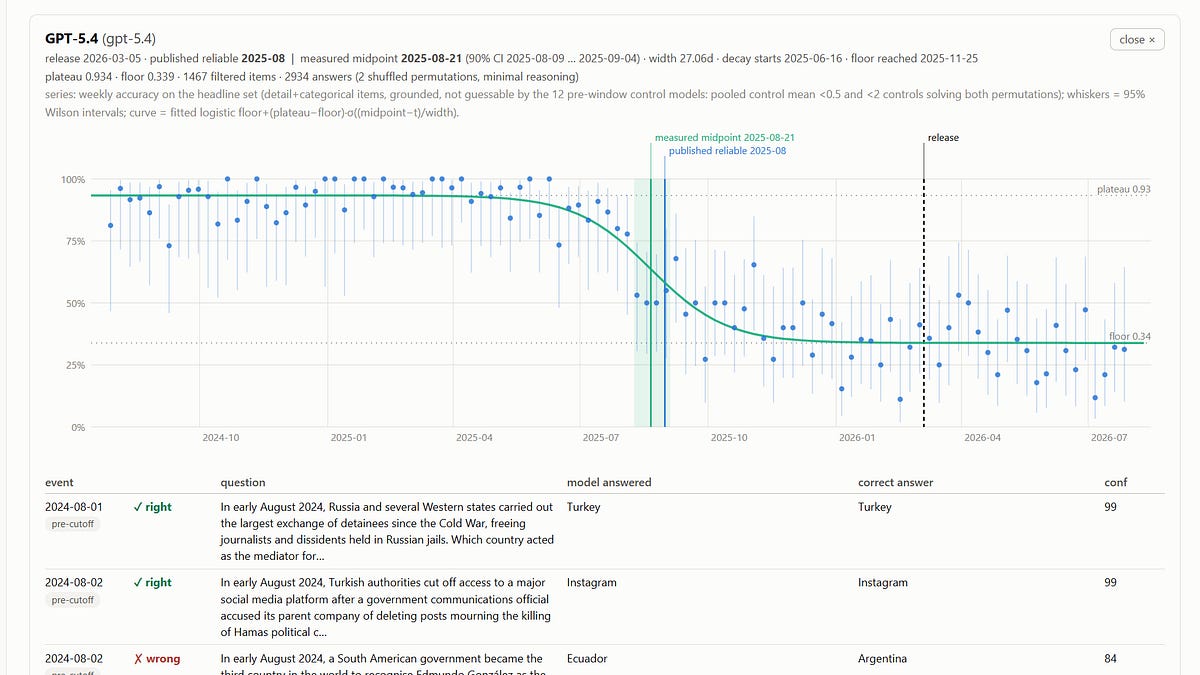
據 Hacker News 討論的一篇未經官方證實的分析文章指出,開發者透過歷史問答與自我認知測試探測前沿模型,藉此推估其預訓練時間線與資料集組成。測試結果推測,Anthropic 的 Opus 4.7 及後續模型皆來自同一次預訓練,知識截止日約落在 2025 年 12 月底。然而,Opus 5 的官方知識截止日雖標示為 2026 年 5 月,但實測顯示其知識量並未超越 2026 年 1 月的基準,此現象在程式碼套件版本的測試中也得到驗證。
OpenAI 的 GPT-5.6 系列則被推測採用獨立於 GPT-5.5 的全新基準點(checkpoint),預訓練約於 2026 年 2 月底完成。測試中也發現,Luna 模型在低推理運算下呈現高錯誤率,導致其產出看似能預測未來的假象。
透過詢問模型當前日期,分析發現同系列模型(如 GPT-4.1 nano 至 GPT-4.1,或 Opus 4.7 至 Fable/Opus 5)會出現垂直分佈特徵,顯示實驗室正積極使用具近期偏好的資料集進行後訓練(post-training),而較小模型自報較舊日期,可能是從舊版教師模型蒸餾(distillation)所致。
此外,在自我認知測試中,模型在無上下文提示時的回答揭露了訓練資料來源。數據顯示實驗室普遍使用過去模型的輸出(如使用者對話)進行訓練;OpenAI 的軌跡依序為 GPT-4、GPT-4o、GPT-4.1、GPT-5 至近期的 ChatGPT,Anthropic 則從 3.5 Sonnet 轉向 Sonnet 4.5。
讀原始報導背景
訓練大型語言模型通常包含預訓練(pre-training)、領域資料微調與後訓練(post-training)等階段,但多數頂尖模型的具體訓練細節與時程並未對外公開。研究人員可透過特定測試方法來推測這些隱藏資訊,例如利用「資料混合推論(Data Mixture Inference)」技術分析分詞器(tokenizer),藉此還原訓練資料的分布組成。
社群討論
網友實測指出 LLM 可能有「分區」的知識截止日,例如能回答 2025 年 4 月教宗逝世與 2024 年 11 月川普當選,卻不知 2025 年 1 月的就職,且軟體功能認知僅停在 2024 年 6 月。自稱 OpenAI 員工澄清 API 模型基本固定,但 ChatGPT 會進行靜默更新(如 GPT-5.6 Sol);其他網友則補充,商業層的系統架構同樣會影響用戶對模型知識的感知。此外,社群對實驗室是否「刻意延遲發布模型」存在分歧,一方懷疑有此策略,另一方則認為市場競爭過於激烈,延遲發布只會流失營收。